Analítica con IA
Construimos la capa semántica, las respuestas en lenguaje natural y la búsqueda con IA sobre Snowflake, para que los equipos y los clientes consulten los datos directamente y cada respuesta muestre su fuente.
Construimos analítica de autoservicio y agentes de IA dentro y alrededor de Snowflake, para organizaciones que ya tienen la base gobernada en su lugar y cuyos equipos todavía buscan información, concilian números y arman reportes a mano. Cortex Agents y Snowflake CoWork responden preguntas en lenguaje natural sobre Semantic Views y sobre los documentos de la organización, las apps de Streamlit in Snowflake cubren las vistas que la gente consulta a diario, y las mismas respuestas llegan a Microsoft Teams y a los productos que usan los clientes, cada una con su SQL o su fuente.
Qué incluye la analítica con IA en Snowflake
La capa de analítica se construye de forma nativa en Snowflake, así que las mismas políticas de acceso se aplican a cada respuesta, para las personas dentro del negocio y para los clientes que la ven dentro de un producto.
- La capa semántica
Las Semantic Views codifican las métricas, las relaciones y los términos de negocio, con sinónimos y consultas verificadas para lo que más se pregunta, de modo que las preguntas en lenguaje natural devuelvan respuestas precisas y citadas. Semantic View Autopilot genera la primera versión en Snowsight, y Semantic Studio, conectado a Git, mantiene cada cambio bajo control de versiones, con Snowflake CoCo en el editor.
- Respuestas en lenguaje natural
Cortex Agents razonan sobre datos estructurados y documentos dentro de Snowflake, junto a los datos, y Cortex Analyst escribe el SQL a partir de las Semantic Views. Snowflake CoWork pone esos agentes frente a los usuarios de negocio, que preguntan, dan seguimiento y actúan en lenguaje natural: las respuestas se rastrean hasta los datos y las consultas que las respaldan, los reportes de Deep Research citan la fuente de cada afirmación y las acciones llegan a herramientas como Slack, Jira y Salesforce a través de conectores de Model Context Protocol (MCP).
- Búsqueda con IA y RAG sobre documentos
Cortex Search ejecuta búsqueda híbrida, vectorial y por palabras clave, sobre contratos, políticas y otros textos, y mantiene el índice al día conforme cambian los documentos, así que los agentes responden con los documentos de la propia organización y citan las fuentes. Cuando los archivos deben convertirse en filas, AI_PARSE_DOCUMENT y AI_EXTRACT los vuelven tablas que la capa semántica puede relacionar, como en el procesamiento de reclamaciones.
- Dashboards y apps de datos
Las apps de Streamlit in Snowflake son la capa de visualización, construida donde viven los datos, y corren con restricted caller's rights, así que cada persona ve solo lo que permite su propio rol. Los dashboards de Snowsight retirados se convierten en apps de Streamlit in Snowflake, y el build decide, dashboard por dashboard, si conviene convertirlo, reemplazarlo con un agente o retirarlo.
- Respuestas donde ocurre el trabajo
Cortex Agents responden en Microsoft Teams y Microsoft 365 Copilot, en aplicaciones internas mediante la API REST del agente y a agentes fuera de Snowflake a través del servidor MCP gestionado por Snowflake, todo sobre las mismas Semantic Views y los mismos roles.
- Analítica de cara al cliente
Dashboards, apps de Streamlit in Snowflake y respuestas de Cortex dentro de un producto de software o de un portal para clientes, distribuidores o socios, en las propias páginas del producto y con su mismo tema visual. Cada cliente ve solo sus propias filas: el discovery elige entre tablas compartidas bajo políticas de acceso a filas, un objeto por tenant o una cuenta por tenant, cada solicitud a un agente queda fijada a un solo tenant y los query tags permiten medir el costo de cada tenant. Los clientes que ya usan Snowflake pueden recibir los mismos productos de datos en su propia cuenta mediante Secure Data Sharing o una Snowflake Native App.
- Gobierno de IA y evaluaciones
Antes de cada despliegue más amplio, las evaluaciones de Cortex Agents miden la exactitud de las respuestas con las preguntas del propio negocio, y los agentes actúan con los roles de cada persona, acotados por un Restricted Session Scope. Los presupuestos de IA y las cuotas por usuario limitan el gasto a lo que fija el negocio.
Cómo se ve dentro del stack
El trabajo corre en la cuenta de Snowflake, los repositorios y el CI del cliente, bajo sus controles de acceso, y los resultados llegan a las herramientas que el equipo ya usa.
- La capa semántica
- Respuestas en lenguaje natural
- Búsqueda con IA y RAG sobre documentos

Cómo llega a producción
Los proyectos siguen los mismos cuatro pasos. Cada sprint entrega software funcionando sobre los datos del cliente, y cada nuevo compromiso se apoya en lo que ya corre en producción.
- 01
Discovery
Un proyecto corto que fija el scope y el precio y muestra el estado actual de los datos.
- 02
Sprints por caso de uso
Cada sprint entrega un incremento funcionando en el ambiente del cliente, un caso de uso a la vez.
- 03
Prueba antes de escalar
Cada caso de uso se comprueba en producción antes de comprometer el siguiente.
- 04
Una práctica que el equipo conserva
El equipo del cliente construye junto al nuestro, así que las habilidades se quedan en la organización.
La analítica de autoservicio depende de los datos que tiene debajo. Cuando los pipelines necesitan reforzarse primero, nuestro equipo de ingeniería de datos se encarga de ese trabajo sobre la base gobernada, y después el build pasa a la capa de analítica y agentes. Openflow, Snowpipe Streaming y Zero-Copy Integrations incorporan los datos de ERP, CRM y recursos humanos de los que salen las respuestas, desde sistemas como SAP, Salesforce y Workday.
El discovery elige un dominio prioritario y las preguntas más frecuentes sobre él, y genera su primera Semantic View. Los sprints por caso de uso convierten eso en respuestas que funcionan, un conjunto de respuestas a la vez: el primer sprint entrega la vista con consultas verificadas y un Cortex Agent sobre ella en Snowflake CoWork o Microsoft Teams, con presupuestos de IA definidos. Prueba antes de escalar significa evaluaciones de Cortex Agents con esas preguntas, más la aprobación de los analistas del cliente, antes de ampliar el acceso. Las definiciones y las configuraciones de los agentes quedan documentadas en Git conforme se construyen, y cada métrica tiene un responsable designado.
La analítica de cara al cliente sigue el roadmap de producto. El discovery parte de las preguntas que los clientes hacen primero y define la forma de servir la analítica, el patrón multi-tenant, el costo esperado por tenant y un plan de sprints con precio. Los sprints ponen pantallas funcionando frente a los clientes piloto desde el inicio, y la prueba antes de escalar mide la adopción y el costo por tenant en uso antes de que la funcionalidad llegue a toda la base de clientes.
Un build definido se cobra por el resultado, y Snowflake factura por consumo: los agentes consumen AI Credits conforme la gente los usa. Nuestra sección de precios muestra cómo se acuerdan el scope y el precio por adelantado. Cuando una respuesta debe convertirse en una acción dentro del ERP o el CRM, la ingeniería agéntica la lleva a la operación diaria, como explica nuestro artículo Snowflake como plano de control de la empresa agéntica.
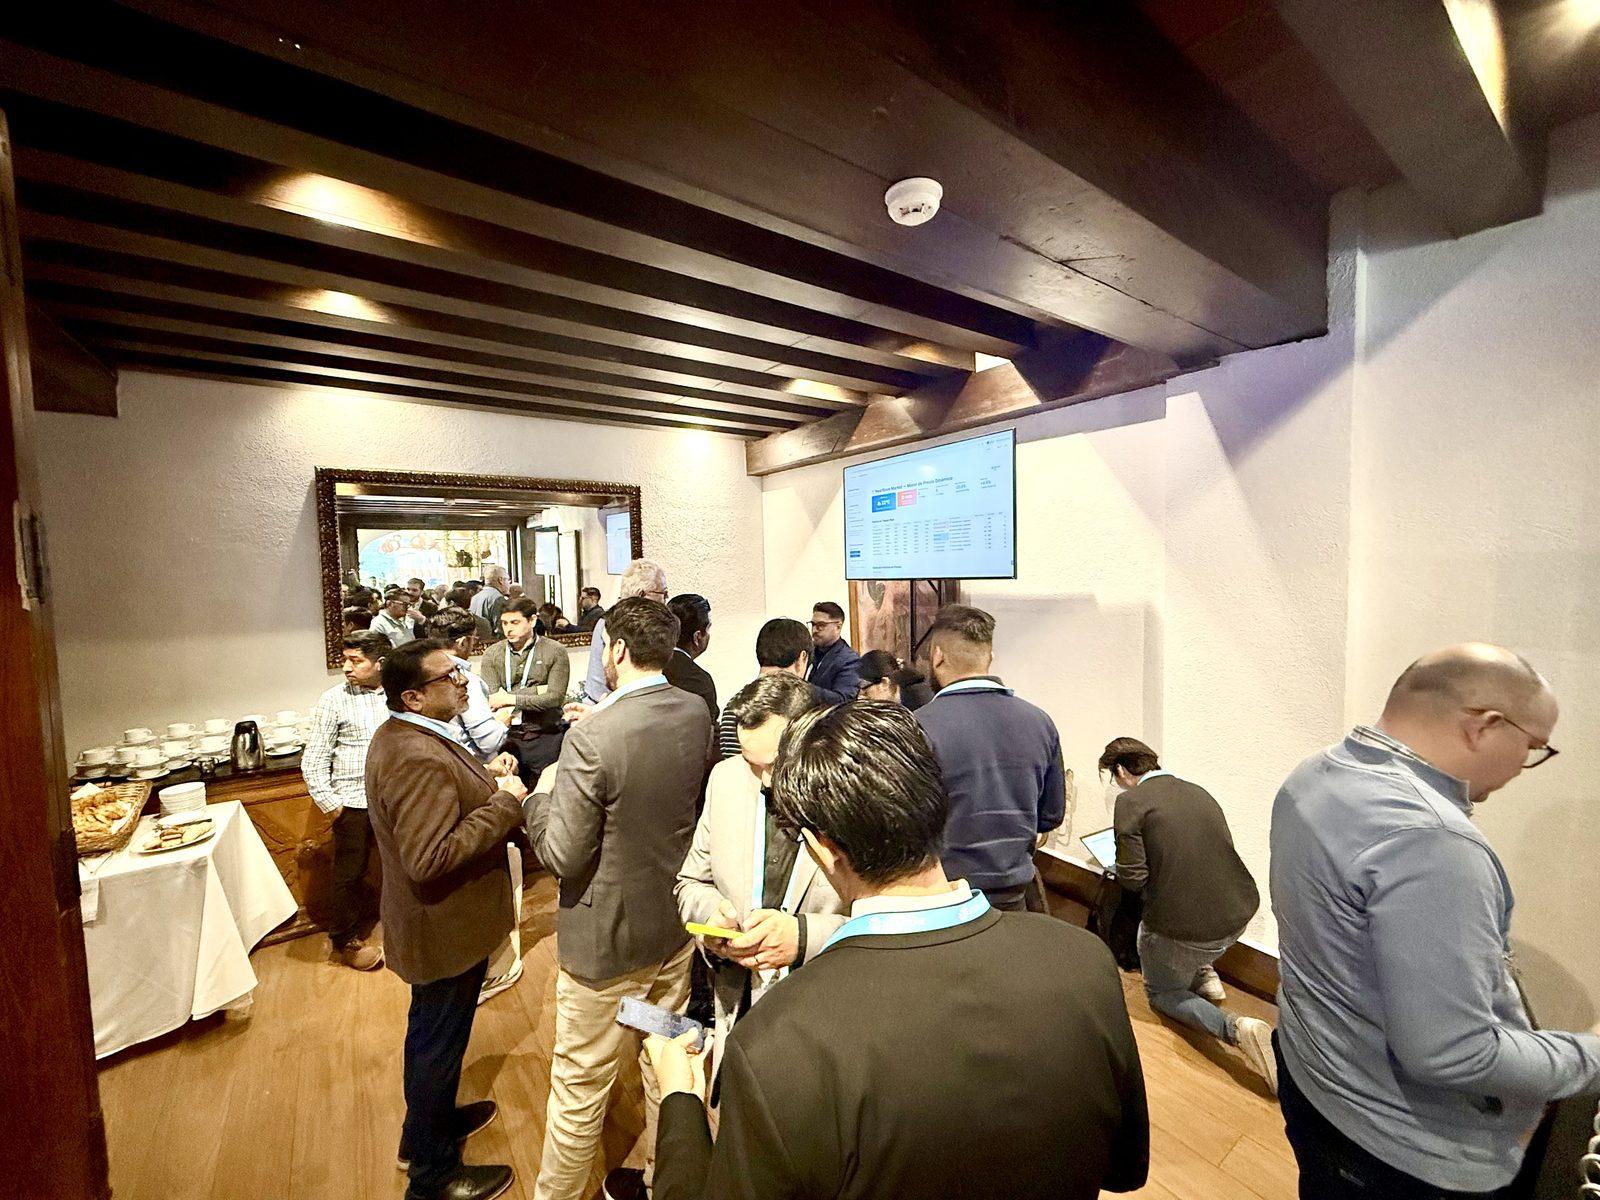
Un buen primer caso de uso es un proceso con un costo medible, en horas, errores o días que se suman al cierre, y con datos al alcance del equipo este trimestre. Esa fue nuestra respuesta a la pregunta que más escuchamos en el Snowflake World Tour Ciudad de México. Con ese proceso y las preguntas que genera como punto de partida, el siguiente paso es hablar con el equipo sobre un discovery diseñado en torno a ellos.
Un equipo nearshore en las mismas juntas de revisión
Afinar la analítica y los agentes depende de la retroalimentación. Alguien hace una pregunta, la respuesta sale ligeramente desviada, un analista explica por qué y la definición se corrige. Ambos equipos comparten la jornada laboral, así que ese ciclo se cierra dentro de ella.
Nuestros ingenieros con certificación SnowPro trabajan desde Monterrey y Austin, en horario del cliente, y participan en las mismas juntas de revisión que los analistas y, en la analítica de cara al cliente, que los product managers y los diseñadores. Escuchan las objeciones de primera mano y las incorporan a las Semantic Views y a los agentes dentro del sprint. El modelo de entrega completo está en nuestra página de nearshore.
El build se documenta sobre la marcha, y los analistas del cliente aprenden el modelo semántico y la configuración de los agentes mientras los construimos. Ya en producción, el equipo interno puede operarlos, o Viewnear puede operarlos como servicio gestionado. El caso del catálogo de SKU es un ejemplo de un fabricante de empaques en México: un agente de Snowflake CoWork, con Cortex Analyst respondiendo sobre Semantic Views, que los usuarios de negocio consultan en lenguaje natural. La base en Snowflake que creamos para una desarrolladora de construcción e inmobiliaria en México reúne agentes de Snowflake CoWork sobre Semantic Views y bots de Slack sobre los mismos datos.
Lo que los equipos preguntan antes de implementar analítica con IA
¿Qué tan preciso es Cortex Analyst?
Tan preciso como su modelo semántico. Cortex Analyst responde únicamente a través de las Semantic Views que se le entregan y muestra la consulta detrás de cada respuesta. La mayor parte de nuestro esfuerzo de implementación se concentra en ese modelo: consultas verificadas, cobertura de los términos del negocio y ciclos de revisión con los analistas del cliente hasta que las respuestas se sostienen. El Cortex Agent que lo invoca pide aclaración cuando una solicitud es ambigua y, antes de abrir el acceso a más personas, las evaluaciones de Cortex Agents miden la exactitud de las respuestas frente a las preguntas que hace el negocio.
¿Necesito un modelo semántico para Cortex Analyst?
Sí. El text-to-SQL sobre esquemas crudos tiene que adivinar qué significa "ingresos" o "cliente activo". Las Semantic Views codifican esas definiciones una sola vez, y Cortex Analyst, Cortex Agents y Snowflake CoWork responden a través de ellas. Hacemos el primer borrador durante el discovery y lo refinamos con el equipo interno en cada sprint. dbt construye y prueba las tablas que están debajo, las Semantic Views guardan las definiciones de negocio que leen los agentes, y las dos capas viven bajo control de versiones. Para un grupo de concesionarios de vehículos comerciales en México, Viewnear está construyendo los golden records dominio por dominio, con agentes de Snowflake CoWork por dominio sobre ellos.
¿Cuál es la diferencia entre Cortex Analyst y Snowflake CoWork?
Cortex Analyst es el servicio que convierte una pregunta en lenguaje natural en SQL sobre Semantic Views, diseñado para integrarse en aplicaciones y flujos de trabajo. Snowflake CoWork es la experiencia de agente que los usuarios de negocio abren directamente para explorar los datos y actuar. Cortex Agents conecta a los dos: un agente llama a Cortex Analyst para los datos estructurados y a Cortex Search para los documentos, Snowflake CoWork funciona sobre esos agentes, y Snowflake hoy recomienda Cortex Agents para los builds nuevos. Un build puede incluir los tres: Snowflake CoWork para las personas, Cortex Agents donde las respuestas deben aparecer dentro de un producto o un proceso, y las apps de Cortex Analyst existentes, que siguen funcionando tal como están.
¿Qué pasa con los dashboards de Snowsight y las herramientas de inteligencia de negocios actuales?
Snowflake retiró los dashboards de Snowsight en 2026, y la opción Generate Streamlit app convierte cada dashboard guardado en una app de Streamlit in Snowflake. El build los clasifica: las vistas que vale la pena conservar se convierten en apps de Streamlit in Snowflake, las preguntas recurrentes pasan a Snowflake CoWork, donde un Artifact guardado mantiene viva una gráfica con los permisos propios de cada integrante del equipo, y el resto se retira. Las herramientas de BI actuales siguen funcionando después de mover los datos a Snowflake, con Snowflake como la fuente que consultan. Las Semantic Views se consultan con SQL estándar, así que esas herramientas leen las mismas métricas que los agentes. Donde importa qué filas ve cada persona, conectamos cada herramienta para que inicie sesión como la persona que la usa, y las políticas de acceso a filas siguen a esa persona.
¿Cómo agrego analítica a mi producto SaaS?
Conviene empezar donde ya viven los datos. Si los datos del producto están en Snowflake, embeber la analítica desde ahí mantiene juntos los datos, su modelo de seguridad y los permisos de acceso. Después se modelan los datos para acceso multi-tenant, se elige el patrón de consumo (dashboards embebidos, aplicaciones con Streamlit in Snowflake o APIs hacia un front end propio) y se libera una primera vista de alto valor con clientes piloto antes de extenderla a todos los clientes. Una app de Streamlit in Snowflake carga en las propias páginas del producto mediante un iframe y un enlace temporal para embeberla, y Cortex Agents, invocados por API REST, permiten que los clientes pregunten y actúen dentro de la aplicación.
¿Cómo funcionan el aislamiento por tenant y la seguridad a nivel de fila (RLS) en Snowflake?
Cada cliente ve solo sus propias filas, y Snowflake lo hace cumplir en cada consulta. En la edición Enterprise de Snowflake, la seguridad a nivel de fila funciona con políticas de acceso a filas que filtran por tenant las tablas compartidas, y los tenants que requieren una separación más estricta reciben objetos propios o una cuenta propia. Las apps embebidas corren con la identidad de la persona que inició sesión, Cortex Agents reciben el tenant como un atributo de sesión inmutable y las consultas a Cortex Search llevan un filtro por tenant. Cada política se prueba por separado antes de que el primer tenant entre en producción, y nuestra página de seguridad y confianza detalla los controles que las rodean.
¿Cuánto cuesta operar Cortex Agents y Snowflake CoWork?
Snowflake factura estas dos funciones de inteligencia artificial por consumo, en AI Credits: Cortex Agents y Snowflake CoWork se cobran por los tokens que procesan, el costo se acumula entre las herramientas que invoca cada agente, y el SQL detrás de cada respuesta corre en el cómputo estándar de los warehouses. El primer sprint define presupuestos de IA por equipo o centro de costos, más cuotas por usuario que bloquean nuevas solicitudes de IA al llegar al límite, y los Resource Monitors ponen tope a los warehouses. En un producto de cara al cliente, las consultas de cada tenant llevan un query tag, así que el equipo de producto fija el precio del plan de analítica con el costo medido por cliente.
¿Los agentes respetan los controles de seguridad y se puede mostrar a un auditor de dónde salió un número?
Sí. Los agentes actúan con los roles de Snowflake de la persona que pregunta, así que el acceso por roles, las políticas de acceso a filas y el enmascaramiento se aplican a cada respuesta, y un Restricted Session Scope puede mantener a un agente por debajo de lo que esos roles permiten. Las respuestas incluyen el SQL o los documentos de origen que las respaldan, el linaje va de cada tabla a la Semantic View y de ahí al agente, y AI Agent Identity registra quién autorizó cada acceso y qué agente lo ejecutó. Los modelos corren dentro del perímetro de servicio de Snowflake, los datos almacenados permanecen en la región de la cuenta y el enrutamiento entre regiones se configura según las reglas de residencia de datos.
Trabajo que ya corre en producción
Cada caso de éxito presenta el problema, lo que construimos y los números, para clientes en Estados Unidos y LATAM.
Leer los casos de éxitoHablar con quienes harían el trabajo
Treinta minutos con alguien que sería responsable del trabajo, y una respuesta directa sobre si hay encaje.
Agendar con
 Eduardo Javier RamosCEOEstrategia, secuencia del roadmap, alianza y términos comerciales
 JC RodriguezDirector de Entrega de ServiciosModelo de entrega, forma del equipo, tiempos y migraciones
 René TreviñoDirector de Inteligencia DocumentalDocumentos no estructurados, precisión de extracción y Cortex AI