Arquitectura en la nube y base gobernada
La base en Snowflake sobre la que corren los reportes y los agentes de IA, con la seguridad y el gobierno de datos diseñados desde el inicio.
Diseñamos y entregamos una base gobernada en Snowflake, con una arquitectura cloud dimensionada para los reportes que los equipos usan hoy y para las cargas de IA que vienen, y con la seguridad diseñada desde la primera tabla. Los reportes y la IA trabajan con las mismas definiciones de negocio, así que cada caso de uso nuevo parte de datos confiables.
Qué incluye una base gobernada en Snowflake
El costo y la seguridad se deciden en la arquitectura, muchas veces años antes de que alguien sienta las consecuencias. Documentamos cada decisión de diseño y construimos junto con el equipo interno, para que quienes van a operar la base sepan cómo funciona cada capa. Una implementación típica cubre:
- Diseño de arquitectura cloud
Topología de cuentas y ambientes, accesos por roles y warehouses organizados para que el modelo de consumo de Snowflake se mantenga predecible conforme crecen las cargas de trabajo. Con DCM Projects, los objetos de Snowflake se administran como código y las mismas definiciones versionadas se despliegan en desarrollo, pruebas y producción, sobre AWS, Microsoft Azure o Google Cloud, en la región que elija la organización.
- Gobierno y contexto para los agentes
Horizon Catalog para linaje y políticas de acceso desde la primera tabla, y Semantic Views que mantienen las definiciones de negocio junto a los datos, para que los reportes y los agentes lean el mismo significado de cada métrica, como en el agente de catálogo construido para un fabricante de empaques. Restricted Session Scope limita lo que un agente puede hacer en nombre de un usuario.
- Identidad y acceso
SSO mediante SAML 2.0 u OpenID Connect, aprovisionamiento SCIM desde el proveedor de identidad de la organización, MFA para usuarios humanos y políticas de red, con roles de acceso otorgados a roles funcionales bajo el principio de mínimo privilegio. La edición Business Critical suma conectividad privada y Tri-Secret Secure, y la página de seguridad detalla los controles auditados de Snowflake junto con nuestras prácticas de entrega.
- Medallion y datos maestros
Capas Bronze, Silver y Gold que resuelven cada fuente en productos de datos y golden records, con reglas de survivorship y linaje diseñados desde el inicio, como en el build de datos maestros de un grupo de distribuidores. Cada regla y cada definición de métrica quedan bajo control de versiones y revisión de código.
- Control de costos
Un warehouse por carga de trabajo para atribuir el gasto, suspensión y reanudación automáticas siempre activas, un resource monitor en cada warehouse y budgets que siguen por equipo los créditos serverless y de IA, agentes incluidos. Snowflake cobra por consumo (créditos de cómputo, más almacenamiento), así que el gasto sigue al trabajo.
- Revisión de arquitectura
Para ambientes que ya están en operación, una revisión de arquitectura de Snowflake audita el diseño, la seguridad y el gasto, desde la topología de cuentas y el diseño de accesos hasta los drivers de costo y la confiabilidad de los pipelines. Entrega una lista priorizada de correcciones, con el razonamiento documentado, para que el siguiente sprint la atienda.
Los casos de uso posteriores reutilizan las mismas definiciones, el mismo modelo de acceso y las mismas capas Medallion, de modo que el siguiente producto de datos o agente parte de trabajo ya probado. Una desarrolladora de construcción e inmobiliaria hoy mide programas, proyectos y decisiones de terrenos contra una sola fuente que incluye los datos de sus planos CAD.
Cómo se ve dentro del stack
El trabajo corre en la cuenta de Snowflake, los repositorios y el CI del cliente, bajo sus controles de acceso, y los resultados llegan a las herramientas que el equipo ya usa.
- Diseño de arquitectura cloud
- Gobierno y contexto para los agentes
- Identidad y acceso
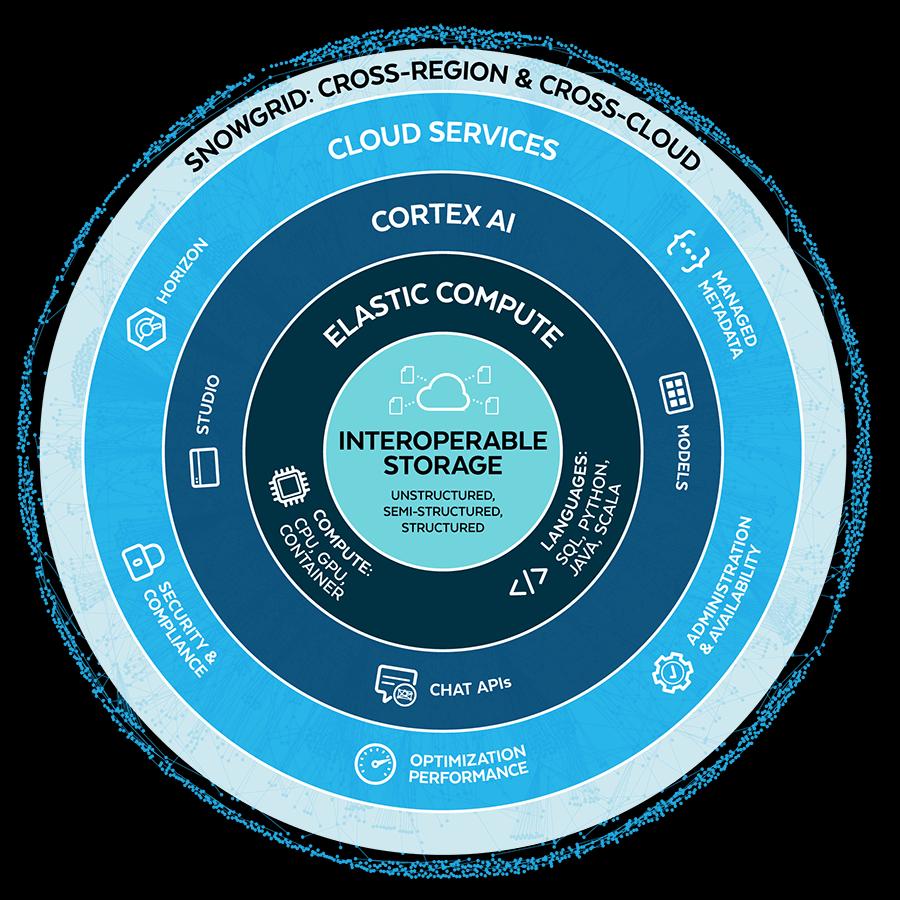
El build, capa por capa
Un build avanza del primer sistema de origen a los agentes en producción, y cada paso usa un conjunto distinto de productos de Snowflake.
Los datos llegan a Snowflake
En los primeros sprints conectamos Openflow a los sistemas ERP, CRM y SaaS que el negocio ya utiliza, y Snowpipe Streaming transporta los flujos en vivo. Las Zero-Copy Integrations leen en origen los datos de SAP, Salesforce y Workday.
Modelados y siempre actualizados
Nuestros ingenieros modelan los datos con dbt y Snowpark donde residen, en código que el equipo del cliente puede leer y ampliar. Las Dynamic Tables mantienen actualizadas las vistas derivadas dentro del target lag que define el equipo.
Gobierno en todo el stack
Nuestros ingenieros configuran el gobierno dentro del equipo del cliente, porque los agentes responden a partir de él. Horizon Catalog aplica las políticas en todo el stack, las políticas de enmascaramiento y de acceso a filas se aplican a los agentes igual que a las personas, y la identidad de agente atribuye cada consulta al agente y a su usuario. El linaje muestra a qué tablas y Semantic Views puede acceder cada Cortex Agent.
Agentes de IA en producción
Los Cortex Agents responden preguntas a partir de las definiciones de negocio, con Cortex Analyst para los números y Cortex Search para los documentos, y Snowflake CoWork lleva las respuestas al negocio, cada una trazable hasta sus datos y consultas. Los resultados también llegan a dashboards y aplicaciones en Streamlit in Snowflake y a las demás herramientas que usan los equipos, donde los agentes leen los mismos datos mediante Model Context Protocol (MCP) y APIs REST. Cinco aceleradores ya corren en producción: DocLens, StatementIQ, UnderwriteIQ, InvoiceMatch y ContractLens leen documentos y escriben registros validados en Snowflake, con un rastro hasta el origen.
Tres pantallas de un build


La lista de componentes
Los productos que usamos, con una línea sobre lo que hace cada uno. dbt es el único framework externo; el resto es nativo de Snowflake. Un punto verde indica disponibilidad general, y lo que está en preview lleva la etiqueta propia de Snowflake. Estatus al corte de noviembre de 2026.
Ingesta y movimiento
Fuentes por lotes, en streaming o vía zero-copy, con las políticas aplicadas desde que llegan.
- OpenflowIntegración gestionada sobre Apache NiFi; entrada por lotes + streaming, salida por reverse ETL, en BYOC o Snowflake Deployments.
- Snowpipe StreamingIngesta continua de baja latencia directamente en tablas de Snowflake.
- Zero-Copy IntegrationsSAP Business Data Cloud, Salesforce Data Cloud y Workday Data Cloud, consultados en origen desde Snowflake.
Transformación e ingeniería
Modelar y transformar dentro de Snowflake, en los lenguajes que el equipo ya usa.
- dbtNuestro framework de transformación preferido, ejecutado de forma nativa sobre Snowflake.
- SnowparkPipelines y UDFs en Python/Java/Scala que se ejecutan junto a los datos.
- Dynamic TablesPipelines declarativos e incrementales que mantienen actualizados los datos derivados.
Almacenamiento abierto e interoperabilidad
Los datos en tablas Iceberg abiertas, legibles para otros motores.
- Apache Iceberg v3Formato de tabla abierto con deletion vectors, linaje de filas y tipos variant.
- Snowflake-managed Iceberg tablesArchivos Iceberg abiertos con lectura y escritura completas desde Snowflake; la compactación y el mantenimiento corren de forma automática.
- Horizon Iceberg REST Catalog APIUn endpoint donde los motores externos leen y escriben las Snowflake-managed Iceberg tables bajo los roles y las políticas de Snowflake.
Gobierno, seguridad y contexto
Linaje, políticas y definiciones de negocio compartidas en las que se apoyan personas y agentes.
- Horizon CatalogLinaje, historial de acceso, clasificación y políticas en todo el entorno.
- Semantic ViewsDefiniciones de negocio compartidas, para que consultas y agentes usen el mismo significado de cada métrica.
- Agent identityMarca las sesiones de los agentes, atribuye sus consultas al agente y a su usuario, y puede limitar al agente por debajo de los privilegios de ese usuario.
- Horizon ContextExtiende Horizon Catalog más allá de Snowflake con metadatos y linaje de bases de datos externas, herramientas de BI y dbt.Public Preview
IA y agentes
Los modelos se ejecutan dentro del perímetro de servicio de Snowflake, y Snowflake ML (Feature Store, Model Registry) también lleva ahí el ciclo de MLOps.
- Cortex AgentsAgentes gestionados que invocan Cortex Analyst sobre Semantic Views y Cortex Search sobre documentos, con evaluaciones integradas.
- Cortex SearchBúsqueda híbrida (vectorial y por palabras clave) sobre documentos y texto, la capa de recuperación con la que responden los agentes.
- Cortex AI FunctionsIA para documentos y texto desde SQL: AI_EXTRACT y AI_PARSE_DOCUMENT leen archivos, AI_CLASSIFY etiqueta texto e imágenes, y AI_COMPLETE ejecuta Claude y otros LLMs.
- Cortex TrainingPost-entrenamiento serverless de modelos open-weight, en GPUs que administra Snowflake, con los datos de entrenamiento y los pesos del modelo dentro de Snowflake.Public Preview
- Snowflake CoCoEl agente de código de Snowflake para ingeniería de datos, analítica, ML y desarrollo de agentes, con cada cambio revisado como diff.
Consumo y aplicaciones
Dashboards, aplicaciones, respuestas, APIs y agentes donde las personas ya trabajan.
- SnowsightLa interfaz web de Snowflake: Workspaces reúne SQL, Python, notebooks y dbt en un solo editor, compartido y versionado en Git.
- Streamlit in SnowflakeAplicaciones de datos interactivas que corren junto a los datos.
- Snowflake CoWorkAnalítica en lenguaje sencillo para todo el negocio.
Cómo se construye la base
Los proyectos siguen los mismos cuatro pasos. Cada sprint entrega software funcionando sobre los datos del cliente, y cada nuevo compromiso se apoya en lo que ya corre en producción.
- 01
Discovery
Un proyecto corto que fija el scope y el precio y muestra el estado actual de los datos.
- 02
Sprints por caso de uso
Cada sprint entrega un incremento funcionando en el ambiente del cliente, un caso de uso a la vez.
- 03
Prueba antes de escalar
Cada caso de uso se comprueba en producción antes de comprometer el siguiente.
- 04
Una práctica que el equipo conserva
El equipo del cliente construye junto al nuestro, así que las habilidades se quedan en la organización.
Elegir con quién implementar Snowflake es elegir la arquitectura con la que la organización vivirá durante años, así que el primer paso es pequeño y se basa en evidencia. Un discovery corto fija el scope: fuentes, cargas de trabajo, requisitos de seguridad y los primeros casos de uso que la base debe atender. Después, la entrega avanza en sprints por caso de uso, con cada pieza comprobada en producción antes de escalarla. El primer sprint configura el ambiente en el que opera el primer caso de uso, con cuentas, roles, políticas de red y resource monitors ya en su lugar. Construimos con Snowflake CoCo, el agente de código, y cada cambio se revisa y se valida antes de llegar a producción. Un build definido se cobra por el resultado.
La práctica de datos y la práctica de IA parten de esta base. Alimenta los pipelines de datos que la mantienen al día, y la analítica con IA y los agentes que la ponen a trabajar. Implementamos soluciones agénticas dentro y alrededor de Snowflake, y esta base es el contexto que esos agentes leen y sobre el que actúan. Si un data warehouse legacy está en el camino, la migración a Snowflake se planea como el primer sprint del mismo build.
El equipo interno opera una base documentada conforme se construyó, con Viewnear disponible como servicio gestionado mientras sea útil.
Profundidad de arquitectura nearshore, en horario del cliente
El trabajo de una base avanza al ritmo de sus decisiones, así que nuestros arquitectos trabajan junto a los equipos de infraestructura y seguridad del cliente. Nuestro hub de entrega en Monterrey, México, trabaja en horario de Estados Unidos, con liderazgo en Austin, Texas, para clientes en Estados Unidos y LATAM. Las revisiones de arquitectura, los vistos buenos de seguridad y las decisiones de scope se resuelven el mismo día en que surgen.
Ingenieros con certificación SnowPro trabajan a diario con la gente de infraestructura y seguridad del cliente, arquitectos senior intervienen en las decisiones de diseño más difíciles, y el equipo interno conserva el control del scope y las prioridades. Viewnear es Snowflake Premier & Select Partner y Snowflake CoCo Preferred Partner.
Preguntas frecuentes
¿Cuánto tiempo toma una implementación de Snowflake?
El discovery define el calendario junto con el scope y el precio, a partir de las fuentes, las cargas de trabajo y los requisitos de seguridad que trae el primer caso de uso. Después, la entrega avanza en sprints por caso de uso, cada pieza se comprueba antes de escalar y el resto del entorno crece por etapas, con productos de datos funcionando en producción desde los primeros sprints. Para un grupo de universidades con varios campus, una base en tiempo real que abarca a más de 20,000 estudiantes en Miami y LATAM entró en operación en siete semanas.
¿Hace falta construir toda la base primero?
No. La base crece a partir del primer caso de uso. Conviene empezar por un problema que ya tiene un número asociado, como las horas que se pierden cada semana, una tasa de error o los días que se suman al cierre, y elegir el caso de uso cuyos datos están al alcance este trimestre. Las tablas, las definiciones y las políticas de acceso que ese caso necesita se convierten en la primera capa de la base, y los casos de uso posteriores las reutilizan. Por dónde empezar fue la pregunta que más respondimos en nuestro stand del Snowflake World Tour Ciudad de México.
¿Qué es una revisión de arquitectura de Snowflake?
Es una auditoría estructurada de un ambiente Snowflake existente que cubre la topología de cuentas, el diseño de seguridad y accesos, los drivers de costo y la confiabilidad de los pipelines, evaluados contra la forma en que Snowflake está hecho para operar, incluido el pilar Security & Governance del Snowflake Well-Architected Framework. Es el health check de Snowflake para una cuenta que ya opera en producción. La revisión entrega una lista de hallazgos priorizada, con el razonamiento documentado, y esa lista se convierte en el backlog de los siguientes sprints. Para definir el scope de una revisión, basta con hablar con un arquitecto.
¿Conviene un lakehouse con Apache Iceberg en Snowflake?
Iceberg tiene sentido cuando otros motores necesitan leer las mismas tablas, cuando el volumen de datos empuja hacia la economía del almacenamiento abierto o cuando la organización adopta formatos abiertos como política. Horizon Catalog gobierna esas tablas con Apache Polaris integrado, y motores como Spark, Flink y Trino leen y escriben tablas Iceberg administradas por Snowflake (incluida la v3) a través de su endpoint Iceberg REST, con los mismos usuarios, roles y autenticación de Snowflake. Las organizaciones que ya operan Snowflake Open Catalog lo siguen usando. Si las cargas de trabajo corren por completo en Snowflake, las tablas nativas suelen ser más simples, y el discovery toma la decisión con base en la evidencia.
¿Cómo se hace cumplir el gobierno de datos en Snowflake?
Las políticas viven en los datos, y Snowflake las hace cumplir en el motor de consultas para cada persona, aplicación y agente que los consulta. El control de acceso basado en roles se modela según la organización, para que cada persona vea solo los datos que necesita, y los datos sensibles se clasifican y enmascaran con etiquetas y políticas de fila y columna conforme se construye cada tabla. Horizon Catalog lleva el linaje y el historial de accesos, por lo que un número se puede rastrear hasta su origen y cada acceso queda registrado para auditoría. El discovery define qué edición de Snowflake requiere cada clase de datos de la organización: Enterprise incluye enmascaramiento, políticas de acceso por fila, clasificación, Access History y linaje, y Business Critical suma conectividad privada, Tri-Secret Secure y failover con Client Redirect. Todo corre dentro de la cuenta de Snowflake del propio cliente.
¿Cómo se construye un golden record a partir de varios sistemas fuente?
Por capas, dentro de la propia cuenta de Snowflake del cliente. Los datos de origen llegan a Bronze, se limpian y conforman en Silver, y se resuelven en registros Gold, con claves maestras, emparejamiento y fusión, reglas de survivorship, linaje y auditoría diseñados desde el inicio. El modelado corre en dbt bajo Git, y cada regla que decide qué valor sobrevive pasa por revisión y pruebas. En un grupo de distribuidores de vehículos comerciales, Openflow carga el ERP, el dealer management system y el sistema de nómina y recursos humanos con una programación incremental nocturna, y produce una sola versión de cliente, vehículo, refacción, proveedor y empleado, cada una trazable hasta su origen. Los ocho dominios de negocio del grupo, desde posventa y catálogos de refacciones hasta finanzas y recursos humanos, llegan en tres lanzamientos a lo largo de una hoja de ruta de doce meses, de modo que los dominios alcanzan su golden record uno tras otro.

Trabajo que ya corre en producción
Cada caso de éxito presenta el problema, lo que construimos y los números, para clientes en Estados Unidos y LATAM.
Leer los casos de éxitoHablar con quienes harían el trabajo
Treinta minutos con alguien que sería responsable del trabajo, y una respuesta directa sobre si hay encaje.
Agendar con
 Eduardo Javier RamosCEOEstrategia, secuencia del roadmap, alianza y términos comerciales
 JC RodriguezDirector de Entrega de ServiciosModelo de entrega, forma del equipo, tiempos y migraciones
 René TreviñoDirector de Inteligencia DocumentalDocumentos no estructurados, precisión de extracción y Cortex AI
Los 5 servicios
- Asesoría de Data + AI
- Arquitectura en la nube y base gobernada
- Ingeniería de datos y pipelines
- Analítica con IA
- Transformación completa